ai coding 半年小结
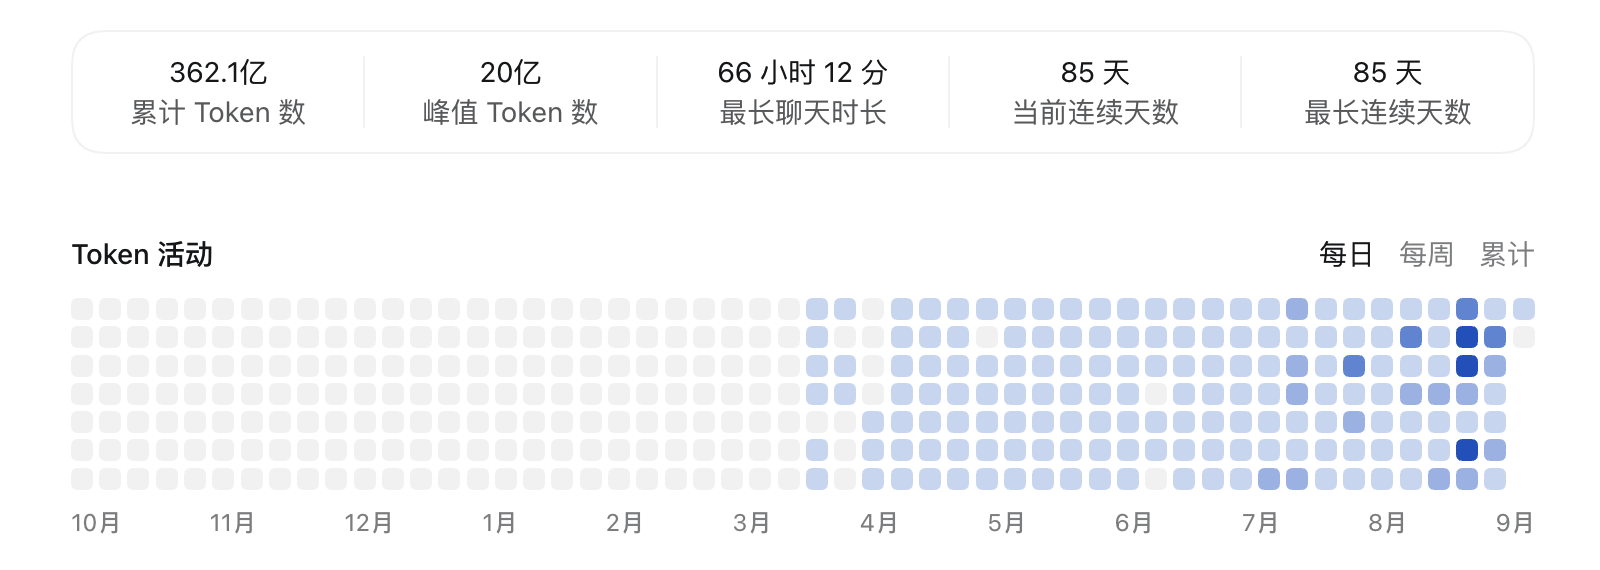
那些历史: vibe-coding
just build, no ship
- 一个通过openclaw 聊天开发上线的站点
- 一份openclaw 个性化配置
- 一个ios app
- 一个macos app
- gorequests 时隔几年 release 了个新版本
- Robert github 协作机器人【服役中】
- apisix-go golang 版本的apisix, 两年前搭了个架子,想不到 agent 能帮我完成接近 100% 的能力平迁
- 2w 行 -> 10w 行 -> 37w 行 -> 48w 行 -> 38 w 行
- ……
vibe-coding 意味着代码都不 review 了,直接合入,纯黑盒,功能正常就行。
那么也意味着,你得不到任何经验。
没有太大意义,大部分都弃坑了,只有少量能用的留下(但是也很快将被淘汰)
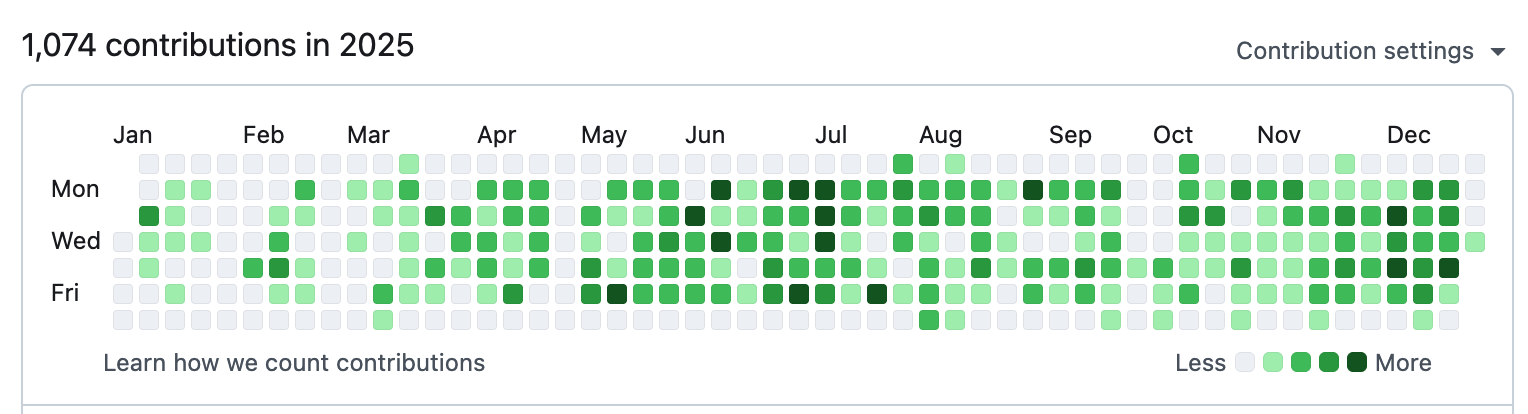
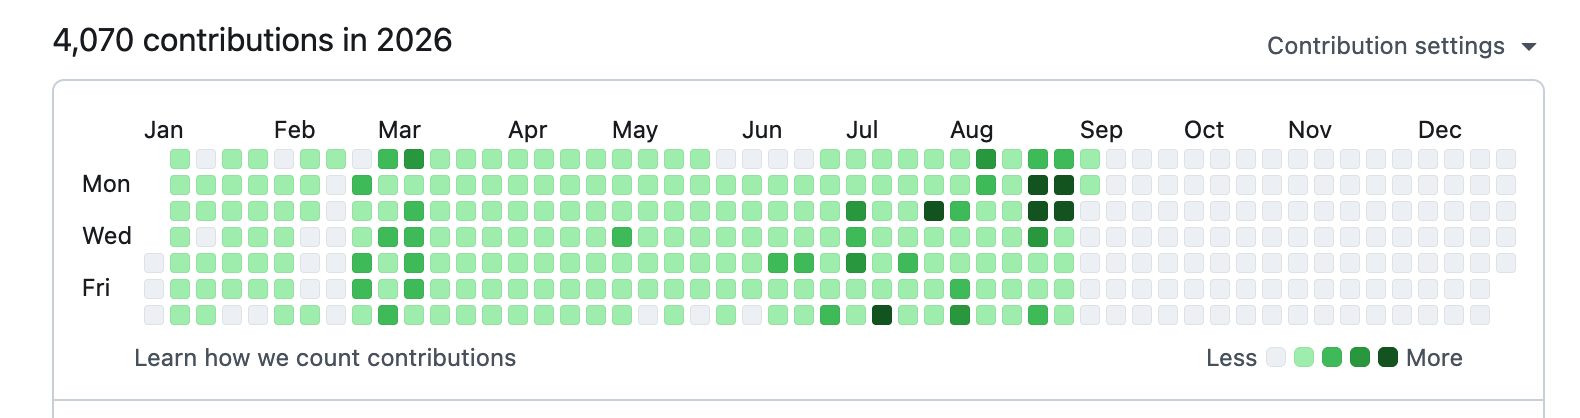
那些历史: openclaw
你还在用吗? 没有了,早格式化了
那么hermes 呢? 装了,删了
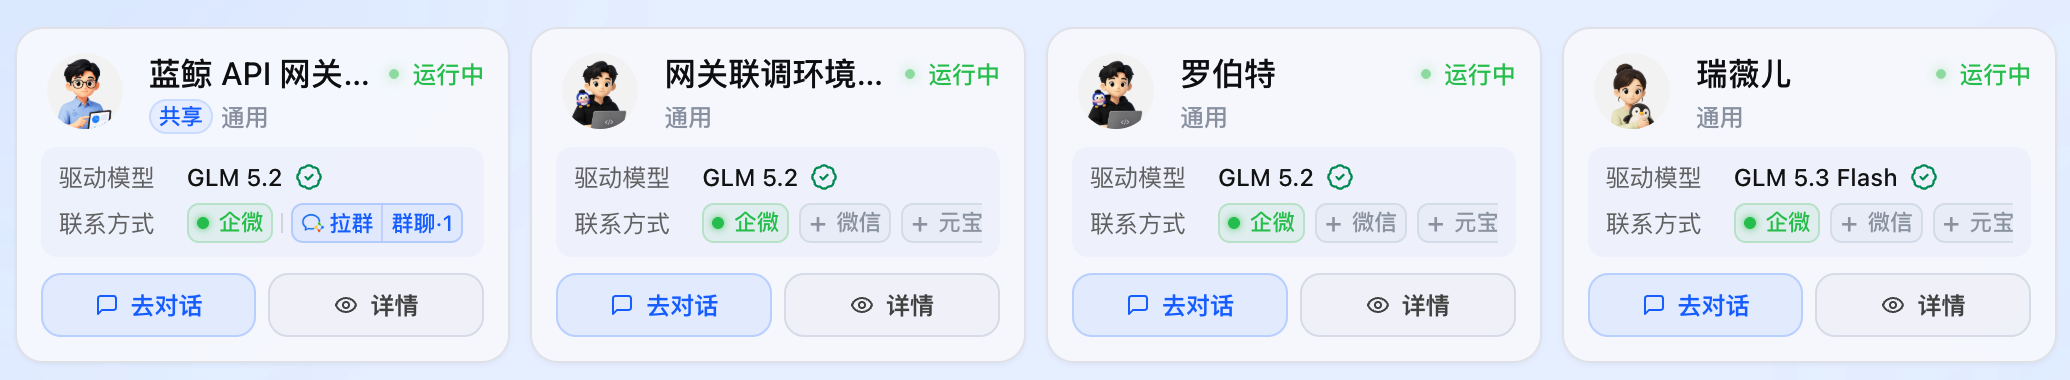
但是,我还在用 imate, 只不过,一个机器人只做一件事情
- github 多模型 review 机器人
- robert 协作机器人
- 问题咨询机器人
- ……
那些有效的部分:agents.md
用 git 维护 AGENTS.md 并且软链所有 agent 使用同一份,迭代,优化
日积月累,加加减减, 最终得到了一份契合自己工作流的约束文档。
玄之又玄,有用没用谁也不知道,但是大部分情况是有用的。
当然,遇到差的模型,白搭。
另外,每一次模型进步,都意味着 AGENTS.md 重塑。 这个文件或许不会消失,但是会越来越小。
- 从最早的一堆
DO NOT, 慢慢的变成一句简单的说明,agent 自主决策
那些有效的部分: 项目 agents.md
每个项目根路径 AGENTS.md + 核心模块目录 AGENTS.md
反复迭代,优化。 慢慢地,agent 能独立自主完成一些需求。
典型项目:
- bk-cli (1.7W 行go)
- 蓝鲸微网关(7 万行go)
那些有效的部分: 启用 memory
你将会得到意想不到的惊喜
- A 项目改一个字段,agent 告诉你 B 项目的接口协议不兼容
- C 项目加一个新配置,agent 问你 D 项目有级联的变更要不要一起提个 PR
- F 项目有个字段不知道哪来的什么原因,agent 告诉你某年某月某日你的一个需求决策
- …..
所以,最好一个机器,一个主力 agent
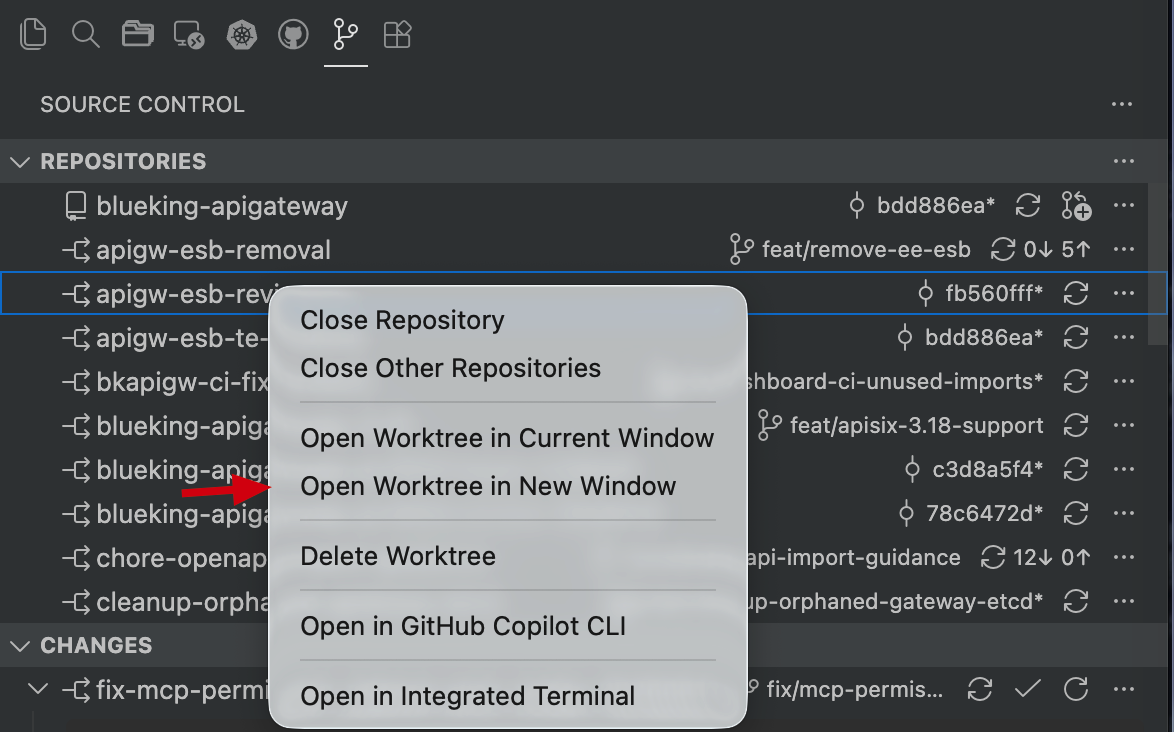
那些有用的部分: 使用git worktree
原先我的所有 SKILL 中, git worktree 是可选,当用户要求用的时候用。
后来,直接变成必选。
场景:多个任务并行
ps: vscode 支持 查看当前所有的worktree 并打开
那些有效的部分: 通用 SKILLS
目标: 让 agent 自动调用这些 SKILL 去完成对应的事情。 不需要你多做派发或说明。
基于 superpowers 构建的 工作流体系,上下层层依赖,打造全面完备的工具入口。
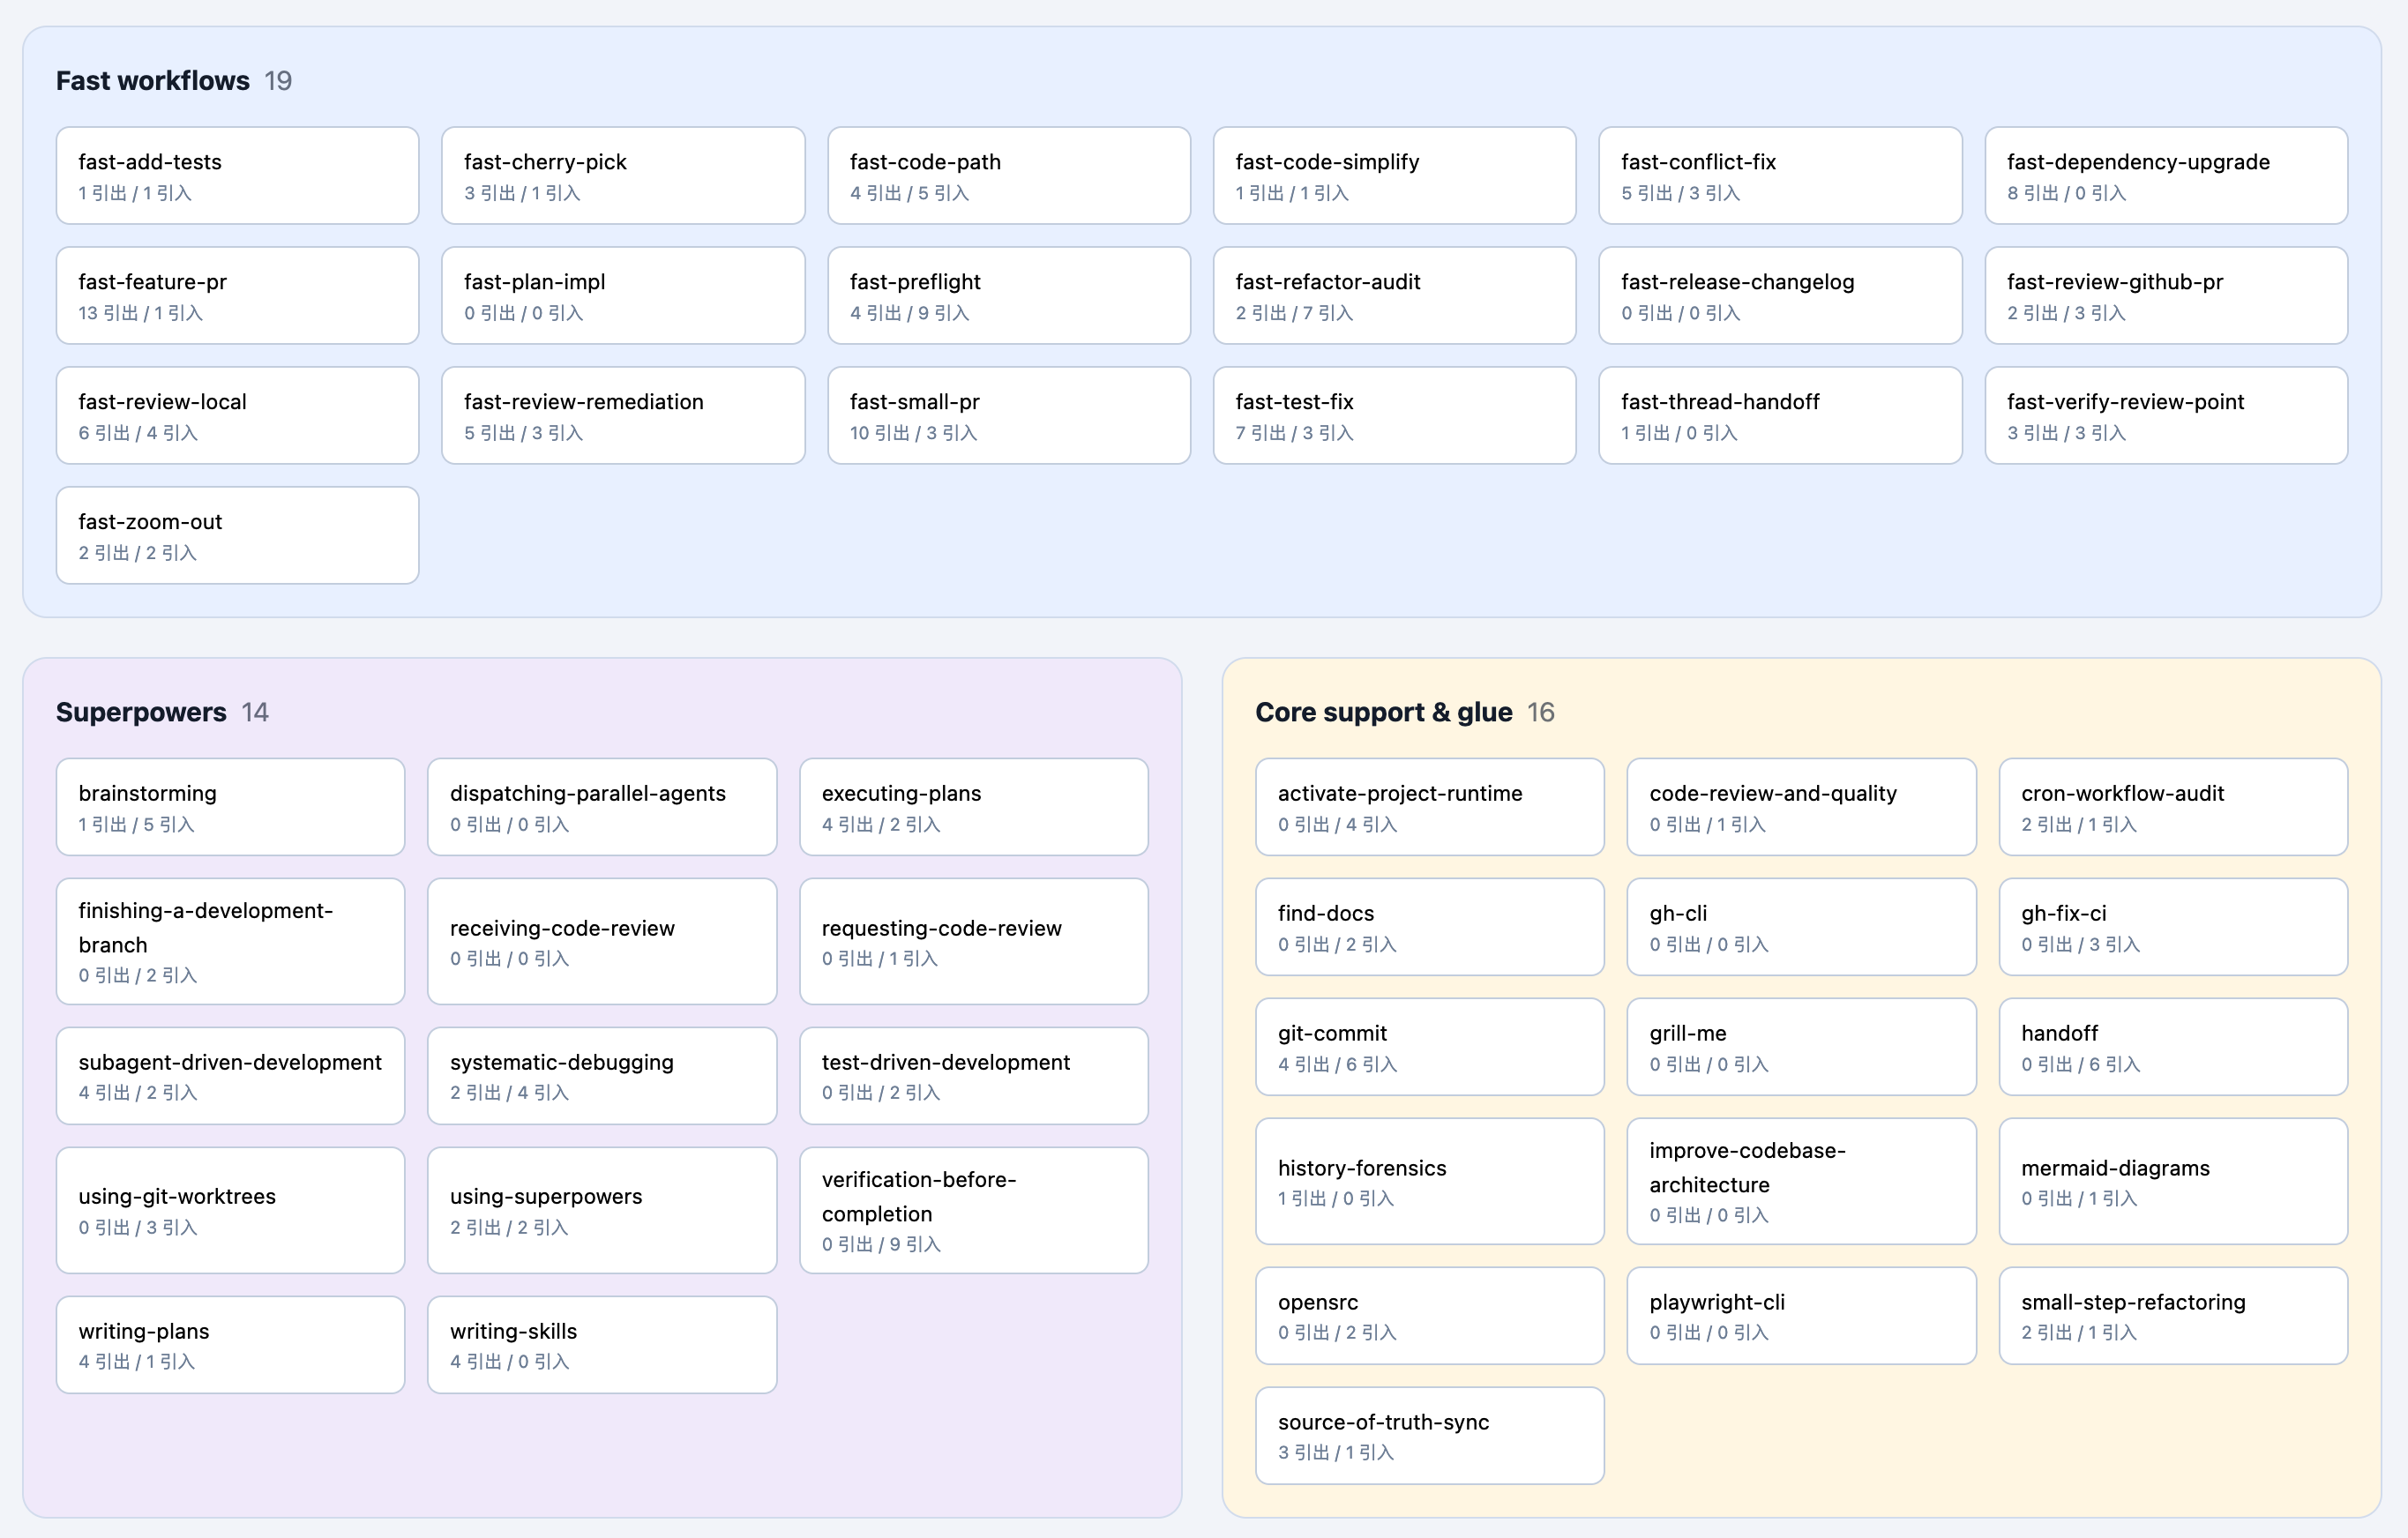
每一次模型进步,都意味着SKILL 得大重写。
gpt 5.5 -> 5.6 -> 6.0, superpowers 直接变成智障,更新到后面的版本才解决。
长期来看, SKILL 会消失,或者被 AGENTS.md 简单几句话直接覆盖。 但是短期,至少目前还是有用的
BTW: 6.0 又进一步简化了 SKILL, 更少的约束,更少的上下文。
那些有效的部分:快捷指令 SKILL
事不过三
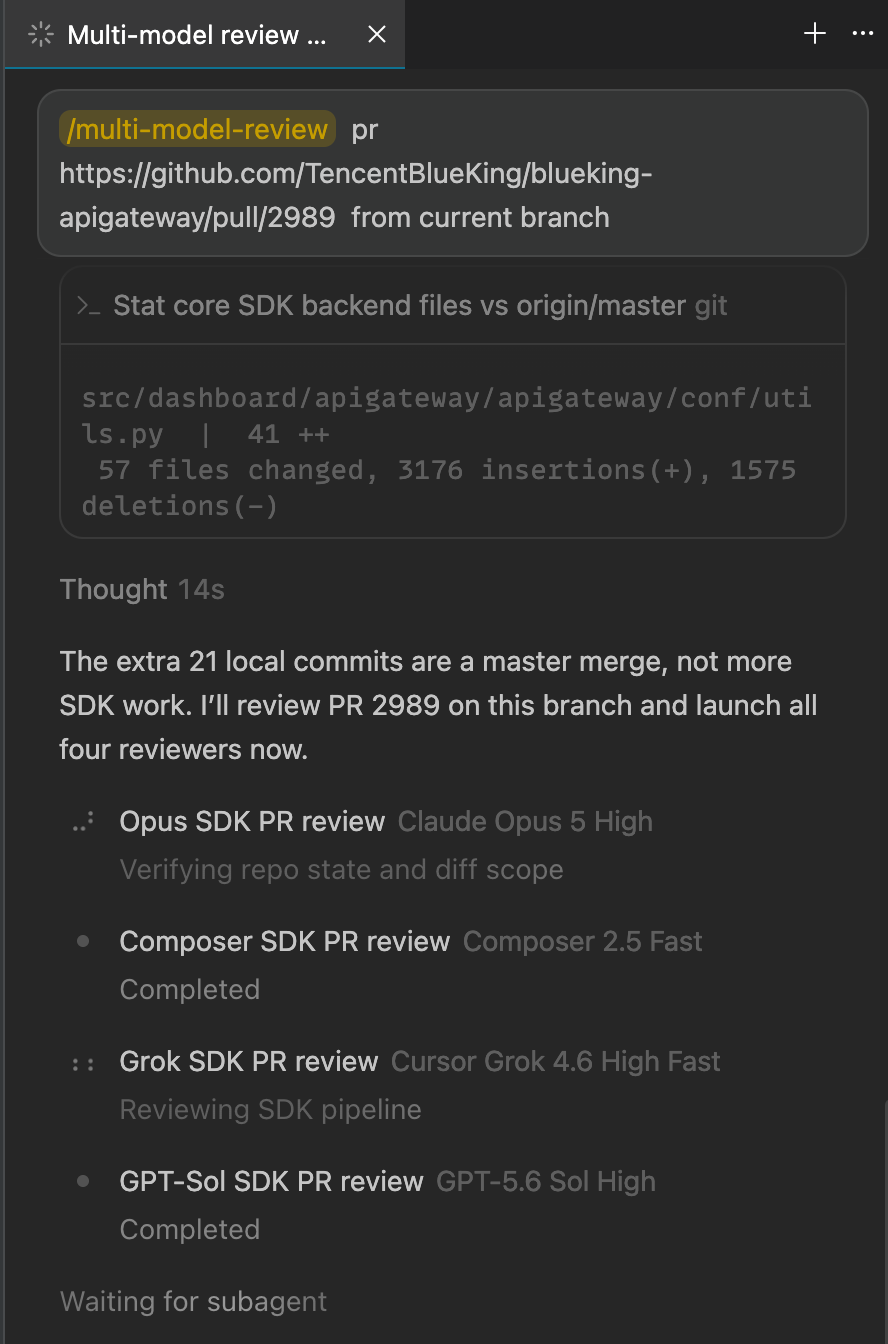
那些有效的部分: 多模型 review
github PR 使用 codex + claude 双模型, 配合本地项目代码自由探索,已经能 reivew 出绝大多数问题
另外cursor 的 /multi-model-review 也可以
汇总 review 报告之后,再选择一个比较聪明的模型进行确认、校验。最终修复那些【正确的】
那些有效的部分: cli and mcp
个人更喜欢 cli + skill,排拆 MCP
但是,这两者在处理确定需求的时候非常有用。
不过,建议克制评估后引入。过多是有害的。
那些有害的部分: 省 token 中间层
个人观点
rtk? graphy? 以及一切中间层。
token 省了多少是可量化的,但是大模型思考返回结果的质量是不可量化的。
纯 bash 流(rg, grep 等)才是最纯粹的。 (古法编程大规模重构中的查找替换)
PS:我支持 LSP,但是目前 codex 并不支持。
那些有害的部分: harness和编排
个人观点
每个人可以通过 AGENTS.md + skills 定制适合自己的开发流。
agent 有两种选择: 1. 大而全例如codex 或 claude 2. 简单可定制 pi or dsh 【我认同这两个方向,受益于 codex 的同时,希望pi or dsh 能够变成未来的一个不可或缺的方向】
但是想要妄图通过一堆 AGENTS.md + skills + 编排工作, 做通用化的 harness(个人很讨厌这个词),统一掉所有项目的开发,那是错误的方向(个人观点)。
- 软约束没啥用,
- 过量的上下文(各种 rules,skills)
- 双份事实(代码一份,harness文档一份),
- 各种中间层(例如 graphy)
- 冲突、歧义、重复等等
对于现在这种中小型项目(20W 行代码以内),轻量的 AGENTS.md + 聪明的 agent 就够了。你不用丢一个语言规范文档给他,丢一个make lint 更有效。
未来应该是类似 pi/dsh 的定制 agent,为每个项目量身配置,加上足够聪明的模型。
那些现在已经不用的部分
你还在用 SDD 吗? 不用了, 文档根本没法 review,最终就是一堆污染(网关各个项目已经删光了)
你还在保留 superpowers 的doc 吗? 全部删掉了,只保留一份事实
你还在用 plan 模式吗? 不用了, gpt 5.6 开始没必要了,模型越来越聪明
你还在用 tdd 吗? 还在用,即使现在很多人认为没有用了
那些现在经常用的部分
- grill-me
- show-me
- fast-*
以及社区不断冒出来的好用的东西
那些建议
- 形成一套适合自己的工作流,agent 也好,skill 也好,cli/mcp 也好,需要反复淬炼,持续迭代优化
- 多跟 agent 聊,追问。
- 技术事实的获取门槛已经很低了,不必去啃书,啃代码
- 但是你自己的理解、判断、决策,最终转换成自己的经验,这个非常重要。
- 多探讨你自己的想法,观点;而不是被 agent 带着走
- 我们始终要和复杂度做斗争, 而现在,agent 变成引入复杂度的源头,代码生成几乎零成本,动不动大几千行往里合,那么,是否整个codebase 还在你的掌控中?
- 务实。 ai coding 炫技很容易,做到务实反而困难。o
那些事实
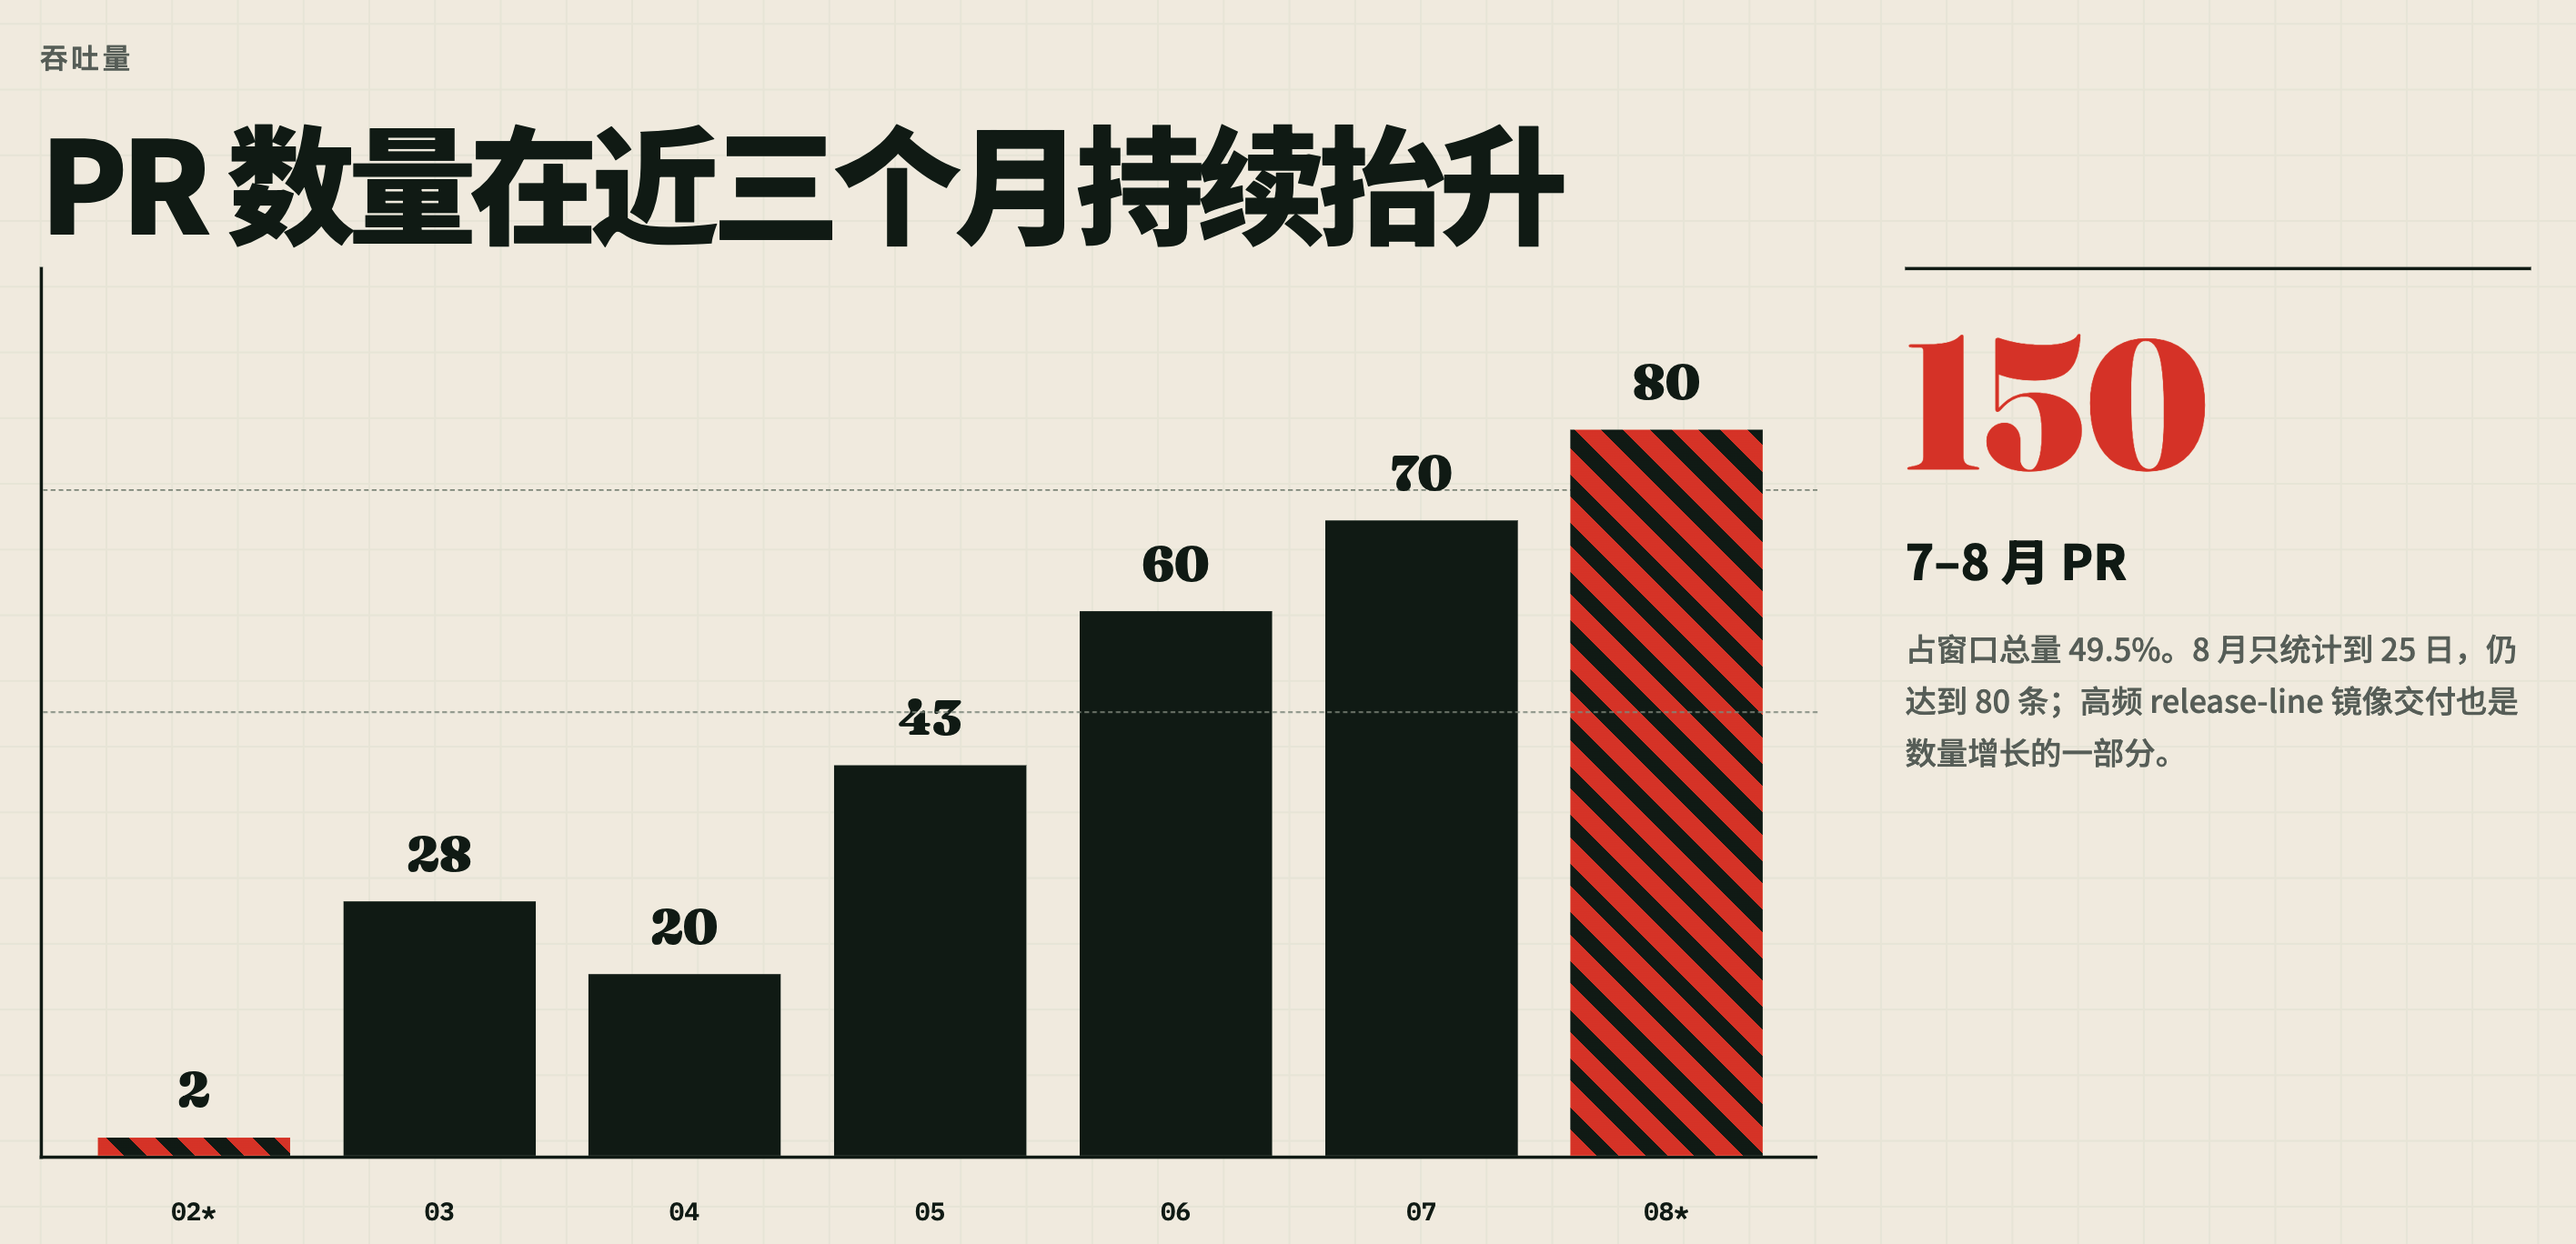
交付的确更高效了,但是也更累了
现在的 gpt 6 Astra low/medium, 已经能非常好的完成和交付任务,非常务实、高效。已经能做很多之前我需要花很多时间做的事情,或者我根本做不到的事情。
幻觉出现的概率越来越低,代码越来越稳。
未来模型肯定越来越聪明,并且也会有类似grok bot 、cloud agent 出现,慢慢地很多工作逐步被这些替代,甚至所有的工作被替代。
但是至少目前,还需要人类开发者来控制复杂度。
也许某一天,控制复杂度也不重要了。